۶ دقیقه مطالعه
فاینتیون یا RAG؟ استفاده از دانش سازمان در مدلهای زبانی
بررسی کاربردها و محدودیتهای بازیابی اطلاعات و فاینتیون، و شرایطی که ترکیب این دو روش میتواند مفید باشد.
یک مدل زبانی عمومی بخش بزرگی از اینترنت را خوانده است. میتواند یک قانون مالیاتی را توضیح دهد یا یک ایمیل مؤدبانه را به سه زبان بنویسد. اما هرگز فهرست قیمت، قراردادها، کاتالوگ محصولات یا پاسخ تیم پشتیبانی شما به درخواست بازگشت وجه را ندیده است. اگر درباره این موارد از آن بپرسید، یا اعلام میکند که نمیداند یا، بدتر از آن، پاسخی میسازد که درست به نظر میرسد.
برای پر کردن این فاصله دو راه اصلی وجود دارد: RAG (تولید با کمک بازیابی) که در آن مدل هنگام پاسخگویی دانش شما را پیدا میکند و میخواند، و فاینتیون که در آن مدل با نمونههایی از کار شما آموزش بیشتری میبیند. این دو روش مسائل متفاوتی را حل میکنند و انتخاب نادرست میان آنها یکی از رایجترین دلایل توقف پروژههای هوش مصنوعی است.
RAG: بازیابی اطلاعات هنگام پاسخگویی
در RAG خود مدل تغییری نمیکند. در عوض، اسناد شما یک بار آماده میشوند:
- به بخشهای کوچکتر، هر کدام چند پاراگراف، تقسیم میشوند.
- هر بخش به یک امبدینگ تبدیل میشود: رشتهای از اعداد که موضوع آن متن را نشان میدهد، بهگونهای که متنهای هممعنی در کنار هم قرار گیرند.
- امبدینگها در نمایهای ذخیره میشوند که برای جستوجوی شباهت طراحی شده است، برای نمونه یک پایگاه داده برداری.
وقتی کسی پرسشی مطرح میکند، پرسش نیز به همین روش به امبدینگ تبدیل میشود، نزدیکترین بخشها پیدا میشوند و در کنار پرسش در پرامپت قرار میگیرند. سپس مدل بر اساس همان متنی که در اختیار دارد پاسخ میدهد.
کاربردها و مزایای RAG:
- دانشی که تغییر میکند. یک سند را بهروز کنید تا پاسخ بعدی از نسخه جدید استفاده کند. نیازی به آموزش مجدد نیست.
- نمایش منبع. چون مشخص است کدام بخشها بازیابی شدهاند، پاسخ میتواند به آنها پیوند دهد و یک کارشناس بتواند آن را بررسی کند.
- کنترل دسترسی. میتوان جستوجو را فقط به اسنادی محدود کرد که کاربر فعلی اجازه مشاهده آنها را دارد.
- سازگاری با هر مدلی. همین نمایه امروز با یک مدل آنلاین و فردا با مدلی که روی سرور خودتان نصب کردهاید کار میکند.
محدودیتها:
- سقف آن کیفیت جستوجوست. اگر بخش درست پیدا نشود، مدل نمیتواند از آن استفاده کند. بیشتر خطاهای RAG خطای جستوجو هستند، نه خطای مدل.
- بخشبندی نامناسب. اگر اسناد را هر چند صد نویسه یک بار تقسیم کنید، جدولها نصف میشوند و تیتر از پاراگراف خود جدا میافتد. تقسیم بر اساس ساختار خود سند (بخشها، ردیفها و بندهای قرارداد) معمولاً نتیجه بسیار بهتری دارد.
- محدودیت فضا و سرعت. متن بازیابیشده بخشی از پرامپت را اشغال میکند و هر پاسخ یک مرحله جستوجوی اضافی دارد.
- رفتار مدل را تغییر نمیدهد. RAG اطلاعات را در اختیار مدل میگذارد، اما قالب پاسخ، لحن یا پرسشهایی را که نباید به آنها پاسخ دهد به مدل نمیآموزد.
فاینتیون: تنظیم مدل برای یک کاربرد
فاینتیون یعنی ادامه آموزش مدل با نمونههایی از همان کار: یک ورودی و خروجی مورد انتظار، صدها یا هزاران بار. وزنهای مدل تغییر میکنند و رفتار جدید بدون نیاز به توضیح دوباره در هر پرامپت حفظ میشود.
کاربردها و مزایای فاینتیون:
- قالب و لحن ثابت. پاسخ همیشه با قالب شما، همیشه به فارسی و همیشه با شماره بند.
- زبان تخصصی. اصطلاحات، اختصارها و شیوهای که متخصصان حوزه شما واقعاً مینویسند.
- پرامپت کوتاهتر. دستورالعملهایی که پیشتر یک صفحه پرامپت را اشغال میکردند، یک بار آموخته میشوند.
- مدل کوچک و سریع برای یک کار مشخص. یک مدل کوچک که برای یک کار فاینتیون شده (برای نمونه دستهبندی درخواستهای پشتیبانی یا استخراج فیلدها از فاکتور) میتواند در همان کار به عملکرد یک مدل عمومی بسیار بزرگتر برسد، با هزینه و تأخیر بسیار کمتر.
محدودیتها:
- به داده باکیفیت نیاز دارد. مدل هر آنچه نمونهها نشان میدهند، از جمله خطاهای آنها، را یاد میگیرد. گردآوری و پاکسازی نمونهها معمولاً بخش اصلی کار است.
- اطلاعات کهنه میشوند. هر آنچه در زمان آموزش درست بوده، در پارامترهای مدل بازتاب پیدا میکند. برای بهروزرسانی آن باید دوباره آموزش داد.
- منبعی ارائه نمیدهد. یک مدل فاینتیونشده نمیتواند اعلام کند اطلاعات را از کجا آورده است.
- محدود شدن تواناییها. اگر مدل بیش از حد روی یک کار آموزش ببیند، ممکن است در کارهای دیگر ضعیفتر شود.
فاینتیون کامل همه وزنها را تغییر میدهد و به سختافزار قدرتمندی نیاز دارد. روشهای کمهزینهتری مانند LoRA بهجای آن، چند ماتریس کوچک را در کنار وزنهای ثابت مدل اصلی آموزش میدهند. این روش حافظه و هزینه را بهطور چشمگیری کاهش میدهد و امکان میدهد برای کارهای مختلف، چند آداپتور جداگانه روی یک مدل پایه داشته باشید.
راهنمای اولیه انتخاب
| پرسش | روش مناسب |
|---|---|
| اطلاعات هر هفته تغییر میکنند؟ | RAG |
| هر پاسخ باید منبع خود را نشان دهد؟ | RAG |
| کاربران مختلف باید اسناد متفاوتی ببینند؟ | RAG |
| مسئله، قالب، لحن یا رفتار مدل است؟ | فاینتیون |
| به یک مدل کوچک و سریع برای یک کار مشخص نیاز دارید؟ | فاینتیون |
| مدل باید زبان تخصصی حوزه شما را روان به کار ببرد؟ | فاینتیون |
ترکیب RAG و فاینتیون
در عمل این دو روش رقیب یکدیگر نیستند. یک الگوی رایج این است که فاینتیون برای رفتار و بازیابی برای دانش به کار رود: مدل فاینتیونشده میداند چگونه پاسخ دهد (با قالب شما، به زبان شما و با اعلام ندانستن در موارد لازم) و بازیابی به آن میگوید امروز چه چیزی درست است. هر روش ضعف روش دیگر را پوشش میدهد.
ارزیابی پیش از انتخاب
مفیدترین کاری که پیش از نوشتن هر کدی میتوانید انجام دهید، ساختن یک مجموعه آزمون است: از پنجاه تا چند صد پرسش واقعی، هر کدام با پاسخی که مورد تأیید یک متخصص است. سپس دو مورد را جداگانه اندازه بگیرید:
- بازیابی: آیا برای هر پرسش، بخش درست در میان چند نتیجه نخست قرار داشت؟
- پاسخ: وقتی بخش درست در اختیار مدل بود، آیا پاسخ درست، کامل و با قالب مناسب بود؟
اگر بازیابی ضعیف است، فاینتیون کمکی نمیکند و ابتدا باید روی بخشبندی، جستوجو و فراداده کار کنید. اگر بازیابی خوب است اما پاسخها از نظر قالب یا کیفیت یکدست نیستند، همانجاست که فاینتیون ارزش هزینه خود را دارد.
ملاحظات متن فارسی
اگر اسناد شما فارسی هستند، دو نکته عملی اهمیت دارد:
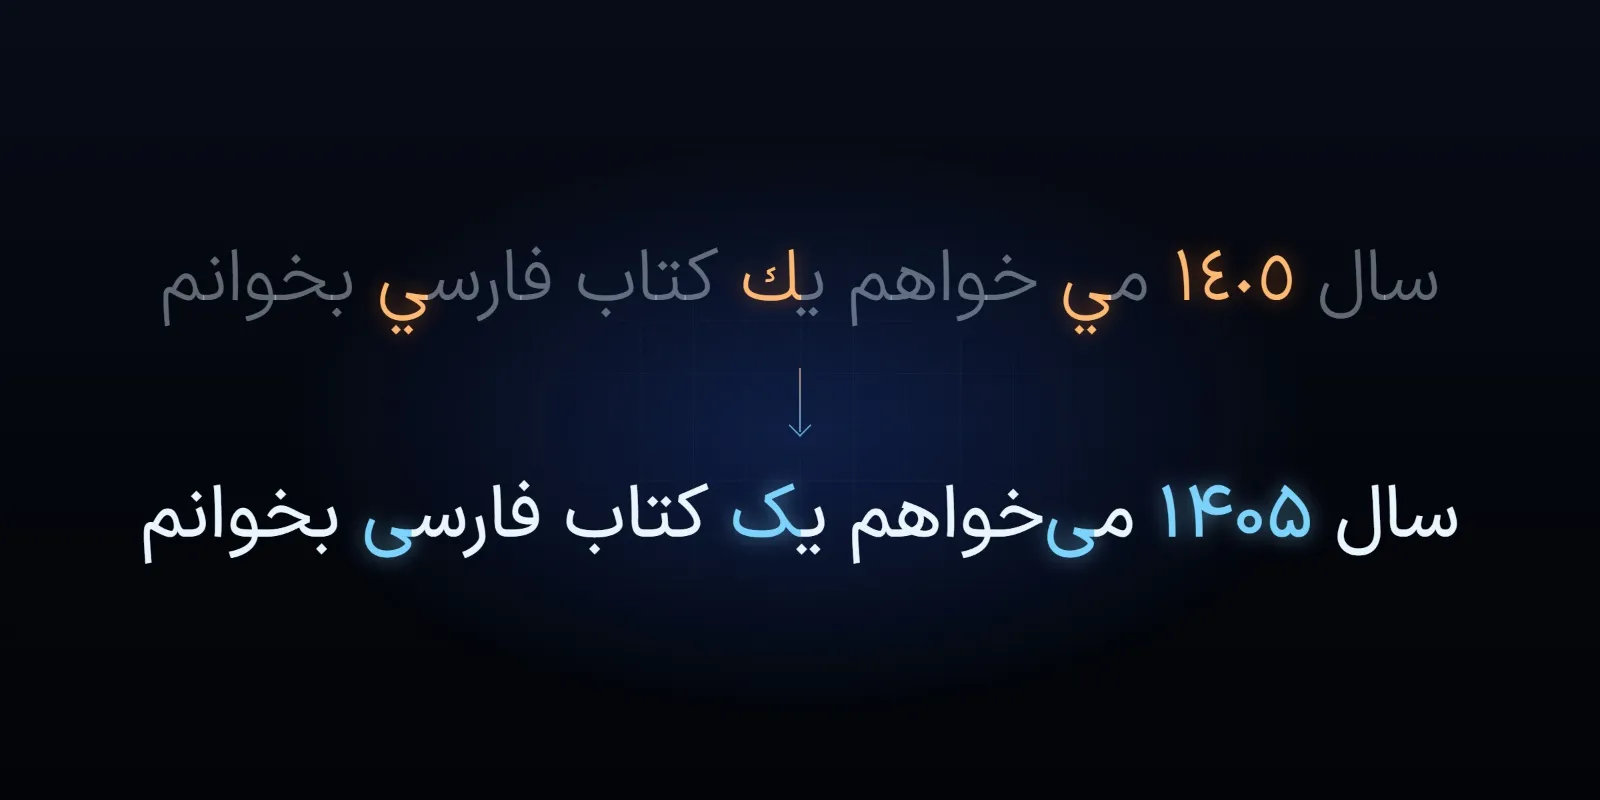
- پیش از نمایهسازی، متن را یکسانسازی کنید. متن فارسی معمولاً شکل عربی برخی حروف (ي و ك) را با شکل فارسی آنها (ی و ک) ترکیب دارد و نیمفاصله نیز بهطور یکدست استفاده نمیشود. از نظر نمایه جستوجو اینها نویسههای متفاوتی هستند؛ بنابراین کلمهای که به دو شکل نوشته شده با خود تطبیق پیدا نمیکند، مگر اینکه هم اسناد و هم پرسشها یکسانسازی شوند.
- توکن بیشتری در نظر بگیرید. توکنایزر بسیاری از مدلها متن فارسی را به توکنهای بیشتری نسبت به متن انگلیسی هممعنی تقسیم میکند. این یعنی هزینه بیشتر و فضای کمتر در پنجره زمینه. بهتر است پیش از برآورد هزینه، این مقدار را با همان مدلی که قصد استفاده از آن را دارید اندازه بگیرید.
برای بررسی روش مناسب استفاده از دانش سازمان در یک محصول هوش مصنوعی، با ما تماس بگیرید.