۶ دقیقه مطالعه
پردازش متن فارسی با هوش مصنوعی: آمادهسازی داده پیش از مدل
تفاوت شکل حروف، نیمفاصله و اعداد میتواند بر جستوجو و پردازش متن فارسی اثر بگذارد. یکسانسازی متن، گامی مهم در آمادهسازی داده است.
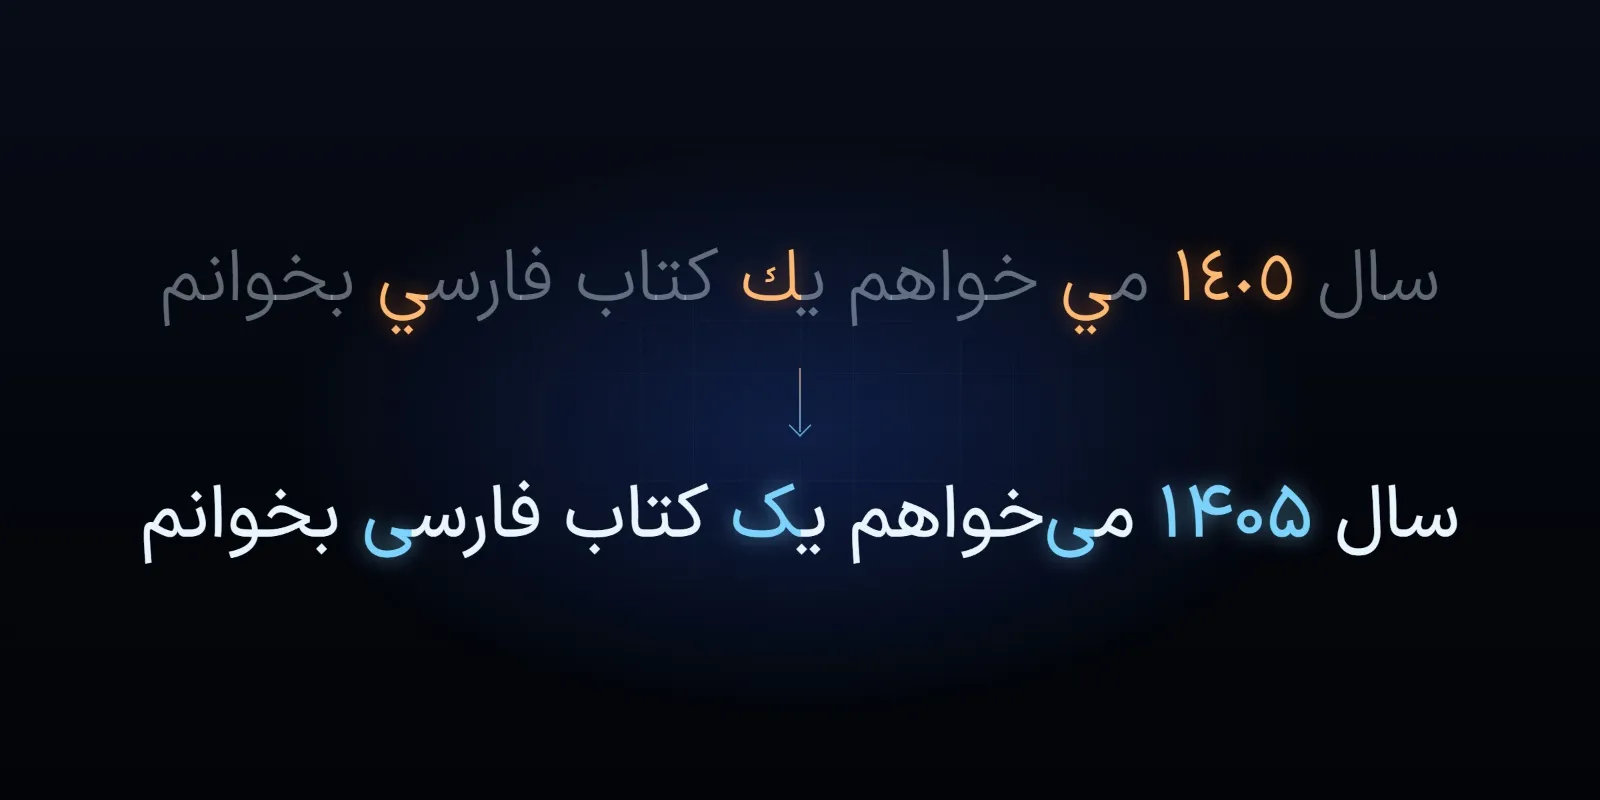
بیشتر ابزارهای هوش مصنوعی عمدتاً با زبان انگلیسی توسعه و آزمایش میشوند. این ابزارها با فارسی هم کار میکنند، اما متن فارسی اغلب به شکلهایی میرسد که بر جستوجو، شمارش و ورودی مدلها اثر میگذارد: دو کلمه که روی صفحه یکسان دیده میشوند، برای رایانه دو رشته متفاوتاند. بخش عمده پردازش درست متن فارسی پیش از آن انجام میشود که مدلی متن را ببیند، و هدف هرچه باشد، از جستوجو و دستهبندی تا چتبات و تحلیل داده، این مرحله یکسان است.
حروف مشابه با کدهای متفاوت
فارسی با نسخه گسترشیافتهای از خط عربی نوشته میشود و دو حرف پرکاربرد آن شکلهای متناظر عربی دارند:
- ی فارسی (U+06CC) و ي عربی (U+064A)
- ک فارسی (U+06A9) و ك عربی (U+0643)
این حروف از صفحهکلیدهای عربی، سیستمهای قدیمی و متنهایی که از منابع دیگر کپی شدهاند وارد متن میشوند. در میانه کلمه شکل یکسانی دارند و خواننده متوجه تفاوت نمیشود، اما برای رایانه «کتاب»ی که با کاف عربی نوشته شده کلمه دیگری است و جستوجوی یکی، دیگری را پیدا نمیکند.
شکلهای دیگر نیز به تصمیم نیاز دارند: اعراب و تنوین، شکلهای همزه و حروف عربیای مانند «ة» که در واژههای قرضی دیده میشوند. راه معمول، یکسانسازی است: برای هر مورد یک شکل انتخاب کنید و همه متن را به همان شکل تبدیل کنید، هم در اسناد و هم در هر عبارت جستوجو، و دقیقاً به یک روش. توجه داشته باشید که آ در فارسی حرفی مستقل است، نه «ا» همراه با علامت، و نباید با «ا» یکی شود.
متنی که از فایل PDF استخراج میشود گاهی شکلهای نمایشی عربی دارد؛ یعنی کدهای جداگانه برای شکل آغازی، میانی و پایانی هر حرف. این حروف درست دیده میشوند، اما با هیچ کلمهای تطبیق پیدا نمیکنند. یکسانسازی NFKC یونیکد آنها را به حروف معمولی برمیگرداند.
نیمفاصله
در فارسی، میان اجزای کلمه از نیمفاصله (ZWNJ، U+200C) استفاده میشود: میان «می» و فعل در «میخواهم» و میان اسم و «ها»ی جمع در «کتابها». کاربران این نویسه را گاهی به شکل نیمفاصله، گاهی به شکل فاصله کامل و گاهی اصلاً تایپ نمیکنند؛ در نتیجه یک کلمه با سه املای متفاوت دیده میشود:
- «میخواهم»، با نیمفاصله
- «می خواهم»، با فاصله، که آن را به دو «کلمه» تبدیل میکند
- «میخواهم»، بهصورت پیوسته
هر ابزاری که متن را بر اساس فاصله به بخشهای جداگانه تقسیم میکند (شمارش کلمات، تطبیق کلیدواژه و بسیاری از توکنایزرهای ساده) در این حالت شمارش و تطبیق نادرستی انجام میدهد. ابزارهای یکسانسازی فارسی حالتهای رایج را اصلاح میکنند: پیشوندهای «می» و «نمی»، «ها»ی جمع و پسوندهایی مانند «تر» و «ترین».
سه مجموعه رقم
اعداد ممکن است با رقم فارسی (۰ تا ۹، U+06F0 تا U+06F9)، رقم عربی (٠ تا ٩، U+0660 تا U+0669) یا رقم لاتین (0 تا 9) وارد شوند و گاهی حتی در یک شماره تلفن با هم ترکیب شوند. برای پردازش، همه را به یک مجموعه تبدیل کنید تا مقایسه، جستوجو و اعتبارسنجی قیمت، تاریخ و شماره تلفن ممکن شود. برای نمایش، اعداد را به شکلی نشان دهید که خوانندگان انتظار دارند: در صفحه فارسی، با رقم فارسی.
تاریخ نیز همین دقت را میطلبد. اسناد فارسی معمولاً از تقویم هجری شمسی استفاده میکنند؛ بنابراین تاریخ باید پیش از مقایسه با تاریخ میلادی تبدیل شود و قالبی مانند «۱۴۰۵/۰۷/۲۹» باید بهعنوان تاریخ شناخته شود.
شیوههای رایج نگارش کاربران
فارسی رسمی نوشتاری با فارسیای که کاربران هر روز تایپ میکنند تفاوت زیادی دارد. گفتوگوها، نظرها، دیدگاهها و پیامهای پشتیبانی پر از نگارش محاورهایاند («میخوام» بهجای «میخواهم»، «رو» بهجای «را») و برخی کاربران فارسی را با حروف لاتین مینویسند که به آن فینگلیش گفته میشود ("salam, chetori?"). مدل یا واژهنامهای که بر پایه متن رسمی ساخته شده، با این شکلها کمتر سازگار است. اگر داده شما از کاربران به دست میآید و نه از متون ویرایششده، روی نمونههایی از همان داده آزمایش کنید و مشخص کنید هر شکل به کدام صورت استاندارد برگردد.
جستوجوی فارسی
یک جستوجوی فارسی خوب همه مراحل بالا را هم روی اسناد و هم روی عبارت جستوجو اجرا میکند و سپس به ساختواژه فارسی میپردازد:
- جمعها («کتابها»، «دانشجویان») و پسوندهایی که به اسم میپیوندند
- شکلهای فعل که از یک بن به همراه پیشوند و شناسه ساخته میشوند («میروم»، «نرفتند»)
- واژههای قرضی که بیش از یک املای پذیرفتهشده دارند
ریشهیاب (stemmer) کلمات را تا یک ریشه مشترک کوتاه میکند و بنواژهیاب (lemmatizer) هر کلمه را به شکل واژهنامهای آن برمیگرداند که برای فعلها نتیجه بهتری دارد. کتابخانه متنباز پایتون هضم (Hazm) برای زبان فارسی، ابزارهای یکسانسازی، توکنسازی، ریشهیابی و بنواژهیابی را در اختیار میگذارد و نقطه شروع مناسبی است.
ملاحظات مدل زبانی
مدلهای زبانی امروزی فارسی را میخوانند و مینویسند و در بسیاری از کاربردها عملکرد خوبی دارند. سه نکته در این زمینه اهمیت دارد:
- هزینه و طول متن: یک متن یکسان معمولاً در فارسی توکن بیشتری از انگلیسی مصرف میکند و قیمت و محدودیت مدلها بر اساس توکن تعیین میشود (توکن را در مقاله مدل زبانی بزرگ چیست و چه محدودیتهایی دارد؟ توضیح دادهایم).
- پیش از نمایهسازی، متن را یکسان کنید. در سیستمی که بر اساس اسناد شما پاسخ میدهد (RAG)، متن برای جستوجو به بردار تبدیل میشود. جملهای که به دو شکل نوشته شده ممکن است دو بردار متفاوت تولید کند و بخش مرتبط پیدا نشود. ابتدا اسناد و پرسشها را به یک روش یکسان کنید.
- به فارسی و با داده خودتان ارزیابی کنید. کیفیت میان زبانها و میان مدلها متفاوت است و تنها نمونههای خود شما، به همان شکلی که کاربران مینویسند، میزان این تفاوت را نشان میدهند. این نکته بهویژه برای یک چتبات سازمانی اهمیت دارد.
چکلیست آمادهسازی متن
- حروف عربی ي و ك را به ی و ک فارسی تبدیل کنید، درباره اعراب و همزه تصمیم بگیرید و آ را حفظ کنید.
- نیمفاصله پیشوندها، جمعها و پسوندها را اصلاح کنید.
- اعداد را برای پردازش به یک مجموعه رقم تبدیل کنید و به خواننده فارسی رقم فارسی نشان دهید.
- روی متنهایی که از PDF و منابع دیگر کپی شدهاند، NFKC اجرا کنید.
- همین مراحل را هم روی اسناد و هم روی عبارتهای جستوجو اجرا کنید.
- روی نمونههای واقعی از متنی که کاربران مینویسند، از جمله متن محاورهای و فینگلیش، آزمایش کنید.
وبسایتها نیز در آدرسها و صفحات جستوجوی خود با همین مسائل روبهرو هستند و چکلیست سئوی سایت فارسی این جنبه را پوشش میدهد. برای گفتوگو درباره سامانهای که متن فارسی را پردازش میکند، با ما تماس بگیرید.